
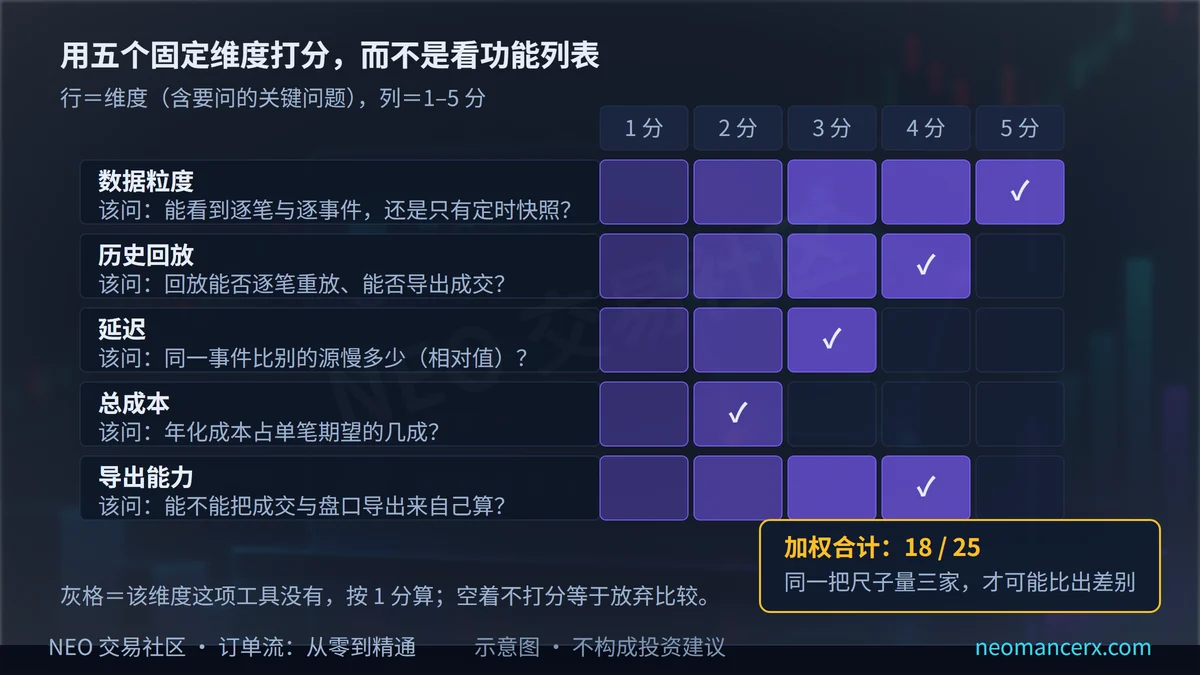
用五个维度打分:数据粒度、历史回放、延迟、成本、导出能力。不看功能列表有多长,只看这五项能不能支撑你的读图方式——本文不点名推荐任何商业产品,只给方法。
一、为什么「功能最多」不等于「最适合你」?
软件的功能列表是营销部门写的,而你的需求是由读图方式决定的。一个把 200 个指标堆在菜单里的软件,如果连「同一毫秒的连续成交」都显示不出来,对你就是没用的。
更麻烦的是,功能本身会制造错觉。你看到「失衡」「吸收」「成交量分布」这些词出现在产品页上,会默认它和你理解的是同一件事。实际上不同软件对同一个词的口径差别很大:失衡是按同档比较还是按对角比较、成交量分布统计的是哪段时间、足迹图的颜色是按买卖量对比还是按绝对值——这些细节决定了你看到的图到底在说什么。
所以评测的第一步不是打开软件,而是先写下你自己的需求清单:你每天要看哪几张图、每张图要回答什么问题、哪些数据是你判断的前提。写完再打开软件,对照着看,而不是反过来被功能列表牵着走。
二、第一维:数据粒度——怎么问才问得清楚?
不要问「有没有逐笔成交」,这个问题厂商一定会答「有」。要问四件事。
第一,成交数据是逐笔还是聚合? 逐笔(tick-by-tick)每一笔都单独一行;聚合(aggregated tick)按固定数量或固定时间合并。聚合会抹掉「同一毫秒多笔」的结构,而扫档(book sweep)恰恰要靠这个结构识别(第 19 篇)。
第二,盘口给的是快照还是事件流? 快照(MBP,market by price)给每个价位的聚合量,事件流(MBO,market by order)给每一笔新单、改单、撤单、成交。只有事件流才能还原「这一档为什么少了 20 手」(第 22 篇)。
第三,时间戳是谁的? 交易所时间戳、数据商处理时间、你本地接收时间,三者不同。做延迟比较前必须问清楚用的是哪一个。
第四,重采样规则是什么? 同一份原始数据,按 100 毫秒聚合和按 250 毫秒聚合,看到的形态不一样。软件是否公开这个规则,直接决定你的图能不能与别人的对照。
四问下来,你基本能判断这个软件的数据处在哪一层。层级不够,后面再花哨的指标都是装饰。
三、第二维:历史回放——回到什么程度?
回放的价值在于「用过去验证现在」,但它能做到什么程度差别很大。
能不能逐事件回放? 只能回放 K 线与成交的回放,和能回放盘口重建的回放,是两种东西。前者你只能看到价格怎么走,后者你能看到当时盘口怎么变薄、怎么被扫穿。
能不能调速度、能不能暂停、能不能逐笔前进? 读订单流本质上是读顺序,快进会破坏顺序感。能单步前进的回放,学习效率远高于只能匀速播放的。
回放窗口有多长? 有的软件只保留最近几个交易日的高频数据,想做跨月对比就必须自己存数据。
能不能导出回放中的数据? 这一条和第六节连在一起:不能导出的回放,只能「看」,不能被检验。
四、第三维:延迟——怎么在自己机器上量?
延迟不该听厂商说「毫秒级」,应当自己量。
最朴素的方法是拿两个源对齐:同一个事件(例如一次明显的扫档)在 A 源与 B 源上出现的时间差。
延迟 ≈ 本地接收时间 − 交易所时间戳
如果拿不到交易所时间戳,就退一步比较「同一事件在两个源上的本地接收时间」,得到的是相对延迟。相对延迟够用:你只需要知道自己的数据比参考源慢多少,不需要知道绝对物理延迟。
量的时候注意三件事:一是至少取几十个事件的中位数,单次测量会被网络抖动骗;二是分时段测,开盘与午盘的延迟经常不同;三是记录你自己的链路(家用宽带、VPS、机房),换环境要重测。
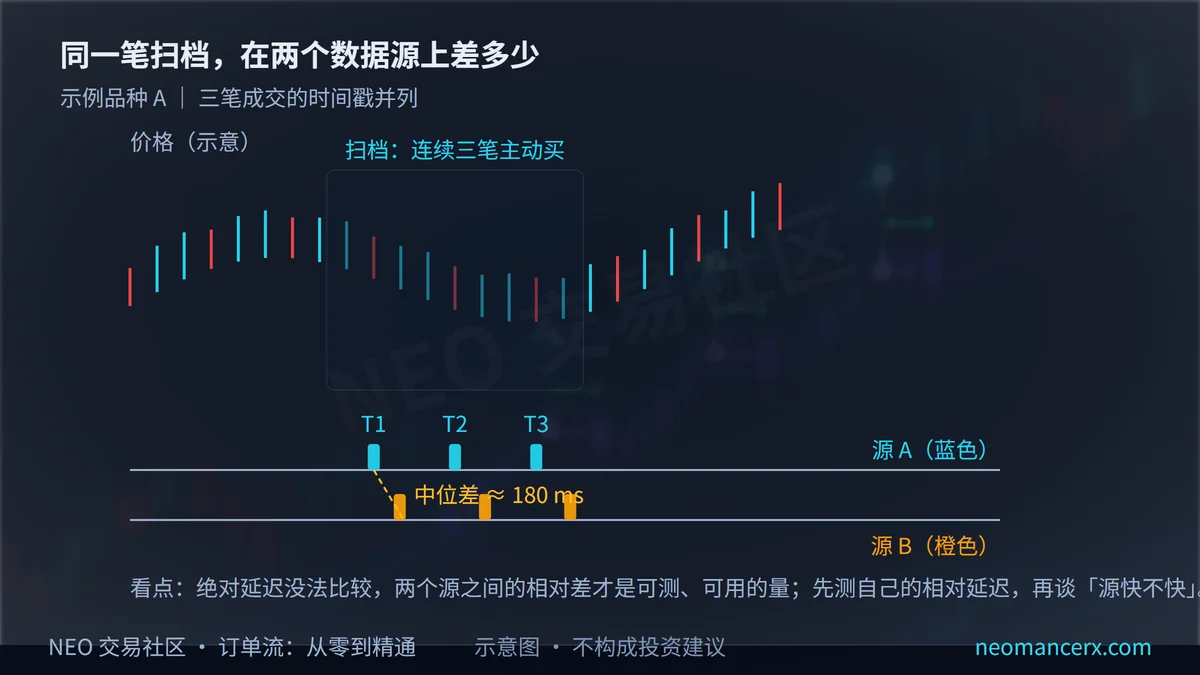
判据可以写得很简单:中位相对延迟小于 1 秒,对日内读图基本够用;超过 3 秒,扫档的「同时性」已经被破坏,你看到的顺序可能和真实顺序不一致。这两个数字是可调的经验值,不是标准。
五、第四维:成本——总拥有成本怎么算?
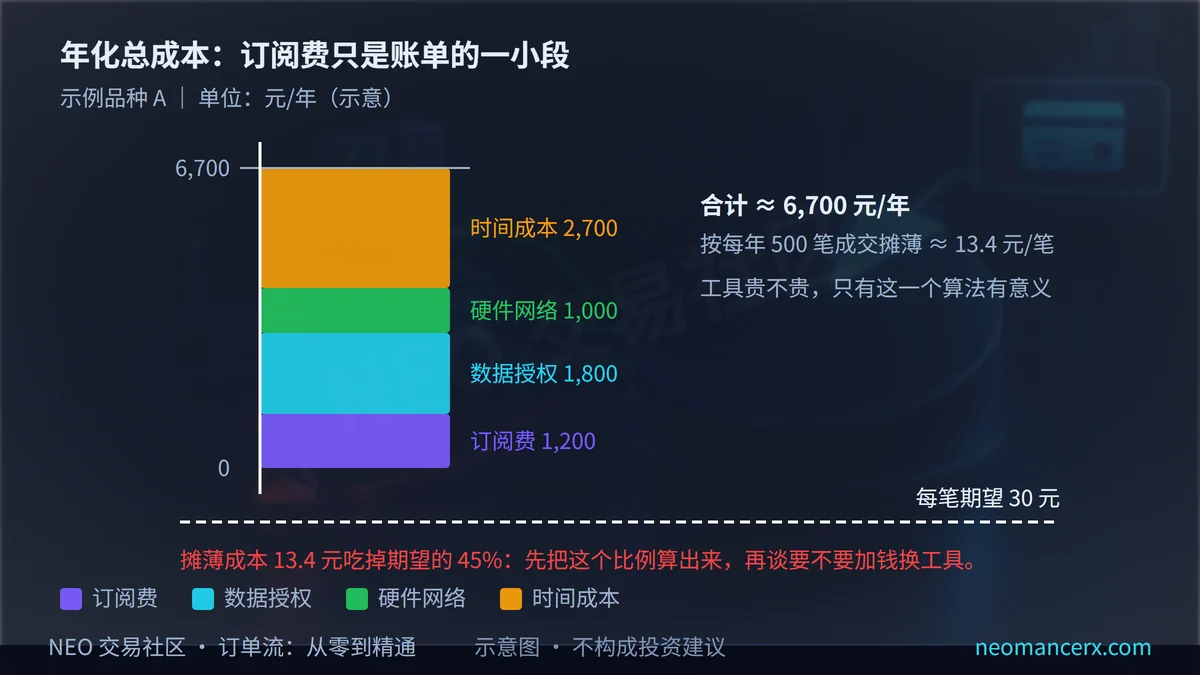
订阅费只是账单的一部分。把四项加起来,才是真实的年化成本:
TCO ≈ 订阅费 + 数据授权费 + 硬件与网络 + 时间成本
数据授权费经常被忽略:交易所的实时行情往往另收费用,按用户数或按交易所计。硬件与网络包括多屏、VPS 或机房的费用。时间成本最容易被低估——学习一套新软件通常要几十小时,这段时间里你没有在研究方法。
把 TCO 除以你一年的交易笔数,得到「每笔摊薄成本」。这个数字的意义在于:如果你的方法每笔期望只有几个跳,而摊薄成本已经吃掉其中一大半,那再好的工具也不划算。这一点和第 16、17 篇讲的摩擦成本是同一件事。
六、第五维:导出能力——为什么它决定你能不能验证?
这一维最容易被当成「附加功能」,其实它是评测里权重最高的一项。
原因很直接:不能导出的数据,你无法做统计检验。你所有的「这个形态好像有用」都停留在印象层面,无法算胜率、无法算期望、无法做样本外验证(第 16 篇)。一个有导出能力的普通软件,长期价值可能高于一个功能华丽但数据锁死的软件。
评测时问三件事:能不能把逐笔成交导出为 CSV 或 Parquet?能不能导出足迹图的分档数据?导出的时间范围有没有限制?第三问很关键——只允许导出最近三天的软件,等于不让你做跨月检验。
七、打分表怎么用,怎么避免被营销带走?
五个维度各打 1–5 分,然后加权:
总分 = Σ (权重ᵢ × 分数ᵢ)
权重按你的读图方式定。如果你主要看逐笔与盘口,数据粒度与延迟的权重应该最高(例如 0.3 与 0.25);如果你主要做复盘与统计,导出能力与回放的权重更高。权重加起来等于 1,写下来,别在试用之后偷偷改——那和改样本没区别。
一个可用的门槛:总分低于 18/25 的,不要考虑;18–21 分的,够用;21 分以上的,通常意味着它在某一维明显强于同侪。这些分数是可调的经验值,不是标准。
试用期里做两件事:一是用它回放你自己最熟悉的三天行情,看它能不能重现你记得的结构;二是导出一份数据,自己算一遍 POC 与失衡,和软件显示的对一遍。对不上,先问口径,再谈好坏。
还有一个反直觉的做法:把你最不满意的那一维单独写下来,问自己「如果这一维永远不改善,我还能用吗」。能,就买;不能,就别指望以后会变好。软件的口径与数据结构很少因为版本更新而改变,它们通常由上游数据源决定,站内关于失衡与足迹的旧文里也提到过这种「工具决定你能看到什么」的限制。
八、这套评分在哪里会失效?
权重是主观的。 同一份打分表,两个人填出来的结果可能完全相反。这不是缺点,是提醒:评测的目的是让你想清楚自己要什么,不是得出一个客观排名。
厂商口径会漂移。 同一个词在不同版本里可能改了定义,试用时的口径未必是半年后的口径。重要指标要定期复核。
免费源也能很好用。 有些公开数据源的粒度足够支撑读图,只是延迟与稳定性不如付费源。评测时不要把「免费」直接等同于「不行」。
工具不解决判断问题。 这一点必须说透:换软件能改善「看得清不清」,不能改善「看得对不对」。第 12 篇讲过的误区,在这一篇里换个形式再出现一次——把工具当能力,是最贵的错觉。
读后自检(三条)
- 五个评测维度你写下来了吗(不是脑子里的感觉)?
- 每笔摊薄成本与每笔期望的比值,你算过吗?
- 换工具能带来的最大改善是哪个维度、大约多少?说不出数字就先别换。
常见问题
Q1:数据粒度是不是越高越好?
不是。粒度越高,数据量与处理成本越大,对硬件与网络的要求也越高。够用就好:如果你只做日内结构判断,逐笔成交加十档盘口通常足够;要做队列与撤单分析,才需要事件流(MBO)。
Q2:延迟多少才算合格?
看你的用法。做日内读图,中位相对延迟在一秒以内基本不影响判断;做秒级以下的操作,延迟就是核心竞争力,这时该考虑机房与专线,而不是换软件。这条界线要先想清楚,再花钱。
Q3:怎么判断一个软件的回放是不是真的?
做一次对照:挑一段你记得很清楚的历史行情,用回放重现,看它能不能还原当时的盘口变薄、扫档位置与成交顺序。还原不了细节的,多半只是把 K 线与成交重新播了一遍。
风险提示
本文只讲订单流工具的评测方法,不构成任何投资建议,也不推荐任何具体商业产品或服务。文中权重、分数门槛、延迟阈值均为可调的经验值,示例行情为虚构示意。期货与杠杆交易可能导致本金全部损失,请独立判断并自行承担交易结果。可继续阅读第 16 篇与站内指标说明,目录见系列总览。
暂无评论内容