
把交易想法变成能检验的假设,要做四件事:写死规则、固定样本、算出基准率、留出一段没碰过的验证集。20 次里 13 次成立,p 值约 0.13,还不足以排除运气;样本不够时先记录、别下结论。
为什么「我觉得这个信号有用」几乎总是不成立?
先说个不太好听的事实:绝大多数「我觉得」不是观察,是回忆。你在图上看到一段走势,回头找当时哪根柱子放量、哪一档失衡,再得出「失衡之后价格走了」——答案是在看到结果之后才被找到的,它不是预测,是解释。「可复现」的标准很朴素:换一个人、换一段时间、只按写下来的规则做,结论不变。
挡在门外的是三件事:记忆的选择性(亏的记不牢、「我当时就看到了」记得牢)、样本不独立(同一天五笔同向交易更像一个样本,共享同一段行情与流动性)、规则事后成型(先认定这一段能赚,再倒推入场条件,规则天生贴合这段数据)。第三件最要命,它是过拟合的起点。
站内订单流基础旧文里有一句话可以拿来当提醒:订单流解释「谁在成交」,不预测「一定涨跌」。同样的克制要延伸到自己的策略上——它解释「这一段发生了什么」,不证明「下一段还会发生」。
20 次里 13 次成立,为什么还不够?
这是本文最需要算清楚的一题。
假设你的信号完全无效,也就是每次「成立」的概率本来就是 50%,和抛硬币一样。那么 20 次里至少 13 次成立的概率,用二项分布的尾概率算:
P(X ≥ k) = Σ(i=k..n) C(n,i) · p₀^i · (1−p₀)^(n−i)
代入 n=20、k=13、p₀=0.5,尾概率 ≈ 0.132。也就是说,一个完全没用的信号,有 13.2% 的概率在 20 次里看起来「13 次成立」。p 值回答的不是「信号有多强」,而是「如果信号没用,出现这么好看的结果有多容易」。按惯例的 0.05 门槛,20 次至少要 15 次成立(p≈0.021);14 次时 p≈0.058,差一点点,仍然过不了。13 次连门槛都没摸到。
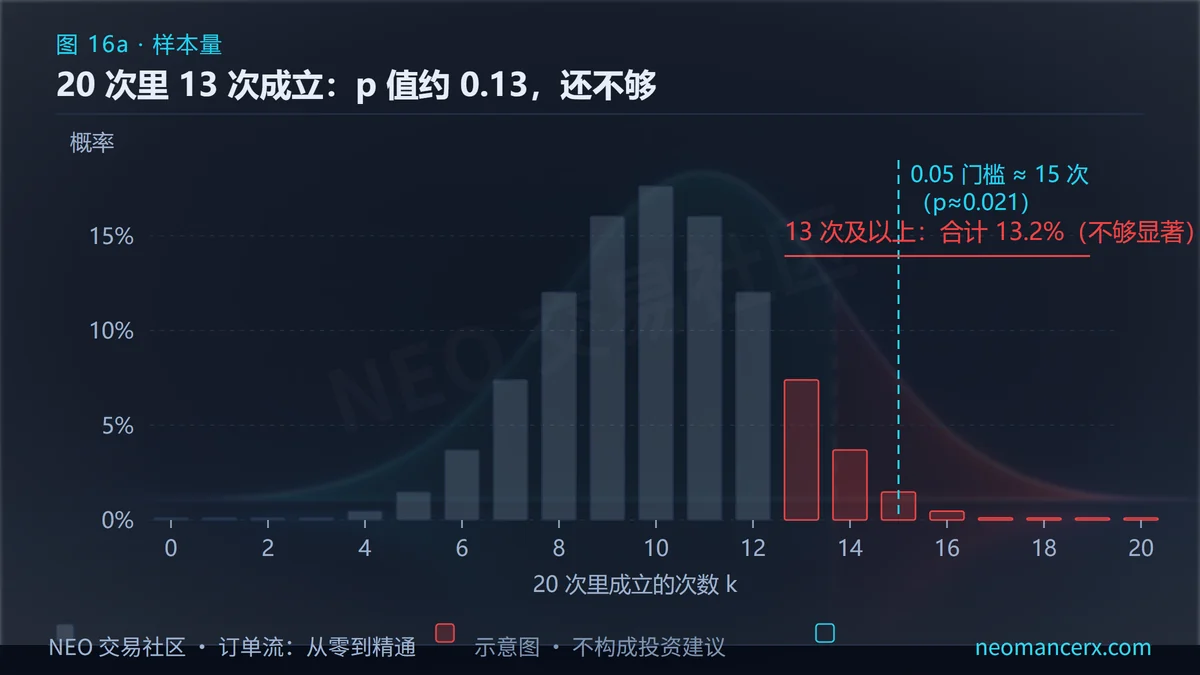
更麻烦的是多重比较。试 10 条规则、只要有一条 13/20 就当成发现,至少出现一次「假阳性」的概率是 1 − (1 − 0.132)^10 ≈ 76%。这就是为什么「我回测过,效果不错」单独拿出来没有信息量——它没说试了多少条。
那到底要多少样本?如果你的目标是估计每笔交易的平均盈亏 μ,且允许误差是 μ 的一半,标准差是 σ,用均值置信区间的近似公式:
n ≈ (1.96 · σ / (0.5 · μ))²
设 σ = 1.2R、μ = 0.15R,则 n ≈ 980 笔;把精度放宽到「误差等于 μ 本身」,n ≈ 246 笔。这就是 30 笔、50 笔的回测结论几乎总不可靠的原因:它们连 100% 的误差都压不住。
基准率与选择偏差:你以为的「有效」可能只是市场本来就在涨
很多「信号」之所以有效,原因不在信号,在基准率(base rate)——市场本身在那段时间就是偏一边的。
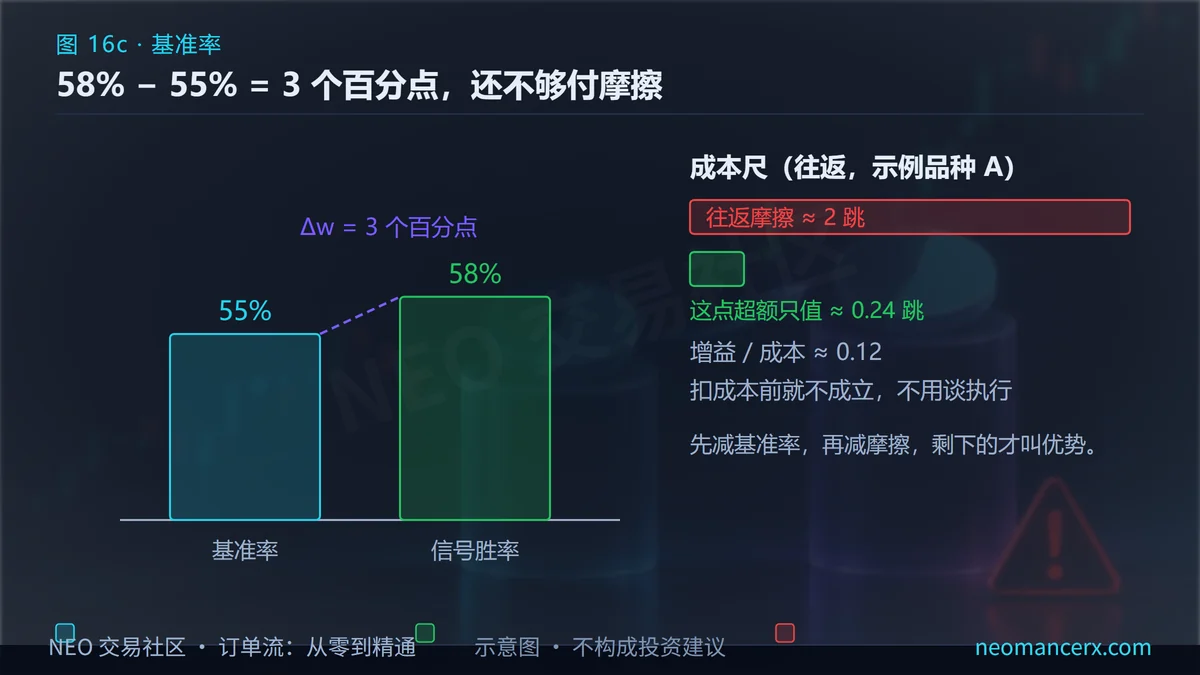
举个可以直接套的算法。假设示例品种 A 在某段样本里,日线收涨的比例是 55%,你设计了一个只做多的信号,实测胜率 58%。看起来赢了,但超额只有:
Δw = w_信号 − w_基准 = 58% − 55% = 3 个百分点
这 3 个百分点要拿去付摩擦成本。若平均盈利 8 跳、往返摩擦约 2 跳,增益只有 0.03 × 8 = 0.24 跳,还不够付成本。记住这个方向:先减基准率,再减摩擦,剩下的才叫优势。
选择偏差有三种常见形态。幸存者偏差:只统计今天还在交易的品种、还在挂牌的合约,已经死掉的样本被剔除,结论自然偏好。前视偏差:用了当时还看不到的数据,最典型的是拿当日收盘后才确定的成交量分布(volume profile)去指导当日盘中入场。样本挑选偏差:先跑一遍,看到某几个月好看就把样本改成这几个月——这一步之后任何检验都失去意义,因为你已经把随机性筛掉了。
对应的纪律只有一条:先写下起止日期和规则,再开始跑;跑完不许改样本,也不许改规则。改了就重开一份记录,旧的留着,它是你判断「我是不是在自欺」的证据。
再补一个订单流的例子。40 个交易日里,「开盘后出现卖方失衡(imbalance)且当日收跌」的有 26 天,胜率 65%;若这段样本本身就有 58% 收跌,超额只剩 7 个百分点。更麻烦的是趋势日的失衡与震荡日的失衡性质相反,混在一起算总胜率等于把两种结构平均掉——按趋势/震荡分组,常看到一边 78%、另一边 41%,问题于是变成「规则适用于哪一组」。分组标准必须提前定,不能看完结果再分。
术语上还有一处必须写清:失衡(imbalance)在产品里是可配置阈值的方向性比较,且有两种算法——横向失衡比同一价位「主动成交(aggressor volume)买量 : 卖量」,斜向失衡比本档与相邻档的跨档差异。两种算法算出的格子不一样,用同一个阈值检验同一句话,结论就会不同。同理,「吸收(absorption)」的业界定义是「大额限价单吸收了相对大量的主动单,可能导致回撤或反转」——是可能导致,不是必然;写成必然,你检验的就不是市场,是自己的措辞。
数据层面还有一条前提:DOM(market depth)是快照,档数可配(5 档 / 10 档 / 全深度),且盘口不等于全部流动性——冰山单与暗池(dark pool)不在公开限价簿上。更要紧的是,两个快照的差值只能说明「少了」,无法区分成交、撤单与改单(100 变成 80 可能是成交 30 撤 10 加 20)。另外每种图统计的事件不同:DOM 数的是待成交挂单量、足迹图(footprint)数的是 bar 内按价分类的成交量、成交量分布数的是区间内按价聚合的量——拿它们的读数当同一个「成交量」,基准率自然偏。
过拟合长什么样:参数一改就崩
过拟合不是玄学,它有很具体的症状,看到其中两条就该停下来。
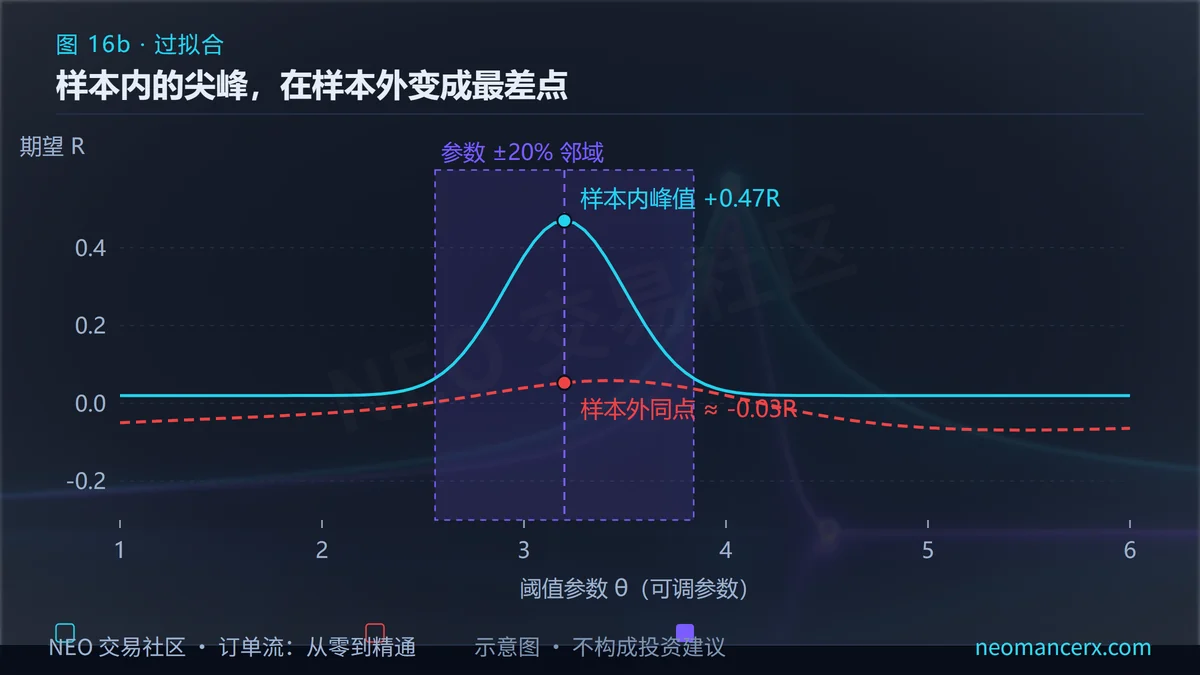
症状一:参数一动就崩。 阈值从 3:1 调到 3.5:1,期望从 +0.2R 掉到 −0.1R——模型拟合的是噪声,不是结构。
症状二:规则越加越多。 每加一个过滤条件(「只做上午」「只做趋势日」),曲线就漂亮一点——这不是发现,是把样本切碎到每段只剩几笔。
症状三:加一个条件后突然变好。 从 0 跃变到 +0.5R,多半意味着这个条件恰好滤掉了那几笔大亏——而那几笔大亏可能本就不该在样本里(数据错误、合约换月),也可能正是这条规则该承受的代价。
给一个可计算的判据,叫邻域稳定性。设参数取 θ 时期望是 E(θ),把参数上下浮动 20% 再算:
S(θ) = min{ E(0.8θ), E(1.2θ) } / E(θ)
S ≥ 0.7 才算稳;S < 0.4 基本可以判定是过拟合。这个判据比「参数是不是整数」有用得多,因为它检验的是结构的连续性,而不是数字的美感。
还有一个经验规则(是经验,不是定理):样本笔数至少是自由参数个数的 30 倍。你有 5 个可调参数,就至少需要 150 笔才勉强能谈稳定性;20 笔配 5 个参数,等于用 4 个点拟合一条三次曲线,怎么调都能过。
可操作流程:写规则 → 固定样本 → 记录 → 再检验
把上面的东西压成一个能每周执行的流程,五步。
第一步,写规则卡。 七个字段:触发条件、方向、入场方式、止损、目标、失效条件、适用时段。触发条件必须可判定(「某档失衡比 ≥3:1 且价格未破该档」),不能是「感觉承接很强」。隔一天自己再读一遍,读不出该做什么就说明没写清。
第二步,固定样本。 时间区间写死,按时间顺序切成样本内 70%、样本外 30%(不要随机打乱,交易有时间结构)。样本外那段,规则定稿前不打开。
第三步,记录。 每笔六列:时间、方向、入场价、出场价、R 值、备注。备注写当时看到的结构,但分析时只看前五列;写理由是为了复盘,不是为了给亏损找解释。
第四步,样本内算四个数。 期望 μ、标准差 σ、胜率、二项 p 值。μ 为正但 σ 极大,说明靠几笔大赢撑着;p 值大,样本还不足以区分信号和运气。
第五步,样本外只跑一次。 跑完按下面的门槛判:
| 样本外结果 | 结论 | 下一步 |
|---|---|---|
| 期望 ≥ 0.5 × 样本内期望,且笔数 ≥ 30,且 p < 0.05/规则数 | 继续 | 小仓位实盘,仓位按最大回撤的 1/4 起 |
| 期望为正但明显衰减(0.2–0.5 倍) | 修改 | 砍掉可调参数,只保留最硬的两条条件,重新固定样本 |
| 期望 ≤ 0 或样本外笔数 < 20 | 丢弃 | 不要「再调一下参数试试」,那是把样本外变成第二个样本内 |
这一步的关键不是严格,而是只跑一次。样本外之所以叫样本外,就是因为它只能被用一次;用第二次它就不叫样本外了。
为什么「回测赚钱」不等于「未来赚钱」?
有四个原因,每一个都足以让正期望变成负期望。
摩擦没算够。 大部分回测按收盘价或中间价成交,实际要付点差、滑点、手续费。毛期望 0.2R 的策略,在 1 跳点差 + 0.5 跳滑点的环境里经常直接转负。
市场状态换了。 波动率、成交量、参与者结构都会变。同一套参数在低波动月份成立,到了高波动月份可能连续失效——不是策略坏了,是它本来就只适用于某一种状态。
你的成交改变了市场。 薄盘口上尤其明显:回测里你能在某一档成交 200 手,实盘里那一档只有 40 手挂单,剩下的以更差的价格成交。
还有个常被忽略的差异:回测里成交是瞬时的,实盘有排队、部分成交、撤单(pulling)。你在某档挂限价单,回测假设必成交,实盘可能只成交三分之一就被甩开;这类差异偏偏集中在最赚钱的几笔上——那几笔往往就是行情最快、最难成交的几笔。
一个务实的做法是打折:样本外期望 × 0.5~0.6 当现实预期,最大回撤 × 1.5。这两个折扣不是推导,是可调的保守假设,应写在规则卡里而不是事后解释。
这篇哪里可能错
这一节必须写,因为本文给出的每个数字都有前提。
二项检验假设每笔独立同分布。 同一天的多笔同向交易高度相关,按「笔」算样本量时有效样本往往只剩一半。修正要按「日」聚合或用块自助法(block bootstrap),本文没展开。
0.05 是惯例,不是自然常数。 它不代表「p=0.049 有效、p=0.051 无效」的断崖;真正该看的是效应大小与稳定性,p 值只是辅助。
30 倍参数的经验规则没有理论保证。 不同市场、不同持仓周期的最佳比例差别很大,把它当起点,不要当判决。
R 值做单位会掩盖尾部风险。 真实亏损分布有长尾(跳空、流动性瞬间消失),用 R 值算出的 σ 偏小,样本量估算因此偏乐观。
基准率本身也在变。 55% 的上涨日比例是某段样本的统计,不是市场的固有属性。基准率一变,超额胜率就跟着变,昨日有效的信号今天可能只剩噪声。
样本外验证会被污染。 只要你打开样本外看了结果,再回头改规则,样本外就变成了样本内。这条没有技术解法,只有纪律。
读后自检(三条)
- 你的规则写死到可以交给别人执行吗?如果只能你自己执行,它还不是规则。
- 样本量够不够?同样的规则在 20 次、200 次上,结论会不会翻转?
- 验证集真的没碰过吗?只要你在上面改过一次参数,它就已经变成训练集。
常见问题
Q1:只有 20 笔记录,能不能看出苗头?
能粗筛,不能定论。20 笔里 15 次成立才刚好 p<0.05,而你可能试了不止一条规则,真实门槛还要除以规则数。20 笔的正确用法是淘汰明显不对的规则,不是确认哪条对。
Q2:一定要做正式的统计检验吗?
不必,但「固定样本 + 留一段没碰过的数据」必须做,它们是所有检验的公共内核。统计只是把「我觉得」换成别人能复核的数字,最省事的做法就是算一次二项尾概率。
Q3:我只有半年数据,样本量上不去怎么办?
降低结论强度,别放宽标准:把结论写成「待验证的筛选器」而不是「策略」,把可调参数砍到 2 个以内,实盘仓位按「随时可能失效」配。样本不足时能加的是约束,不是乐观。
风险提示
本文只讲假设检验与统计口径,不构成任何投资建议,也不预测任何品种的涨跌方向。文中数字均为示例,只用于说明计算方法,不代表真实市场结果,也不代表任何收益承诺。期货与杠杆交易可能导致本金全部损失,请独立判断并自行承担交易结果。想把成本这一侧算清楚,可继续读执行微观结构,或从开始学习按路径推进。
暂无评论内容